AI에게 코드를 맡기기 전에 만든 것들
규칙만으로는 AI가 쓰는 코드가 정리되지 않아 개발 단계를 직접 만든 기록입니다.
올해 3월부터 AI로 코드를 쓰기 시작했습니다. 회사가 AX 전환을 하면서 자연스럽게 그렇게 됐습니다. 백엔드 저장소에 AI와 함께 쓴 첫 커밋이 남은 날은 3월 16일입니다.
규칙은 있었습니다. 3월에 코드 컨벤션을 CLAUDE.md에 적었고, 5월에는 동료가 그 규칙을 hook으로 강제했습니다. console을 쓰거나, 계층 밖에서 DB에 접근하거나, 정해진 형식이 아닌 예외를 던지면 편집 자체가 막혔습니다.
그런데도 코드가 중구난방이었습니다. 규칙은 "이렇게 쓰지 마라"까지만 막아 줬습니다. 무엇을 만들지 정하고 지금 코드 구조를 확인하는 단계는 없었습니다. AI는 비슷해 보이는 기존 코드를 그대로 따라 했고, 코드에 없는 사실을 말하거나 추론으로 빈칸을 채웠습니다.
그래서 5월 27일, 개발을 네 단계로 나눴습니다. 지금은 9월에 더한 리뷰 단계까지 다섯 단계입니다. 기본 순서는 resting → implement → pre-commit-review → ready이고, 제품 결정이 남았으면 맨 앞에 grill을 둡니다.
grill이 정리한 요구사항을 resting이 명세서로 만들고, implement가 그 명세서대로 코드를 씁니다. pre-commit-review와 ready는 커밋 전에 그 결과를 검증합니다.
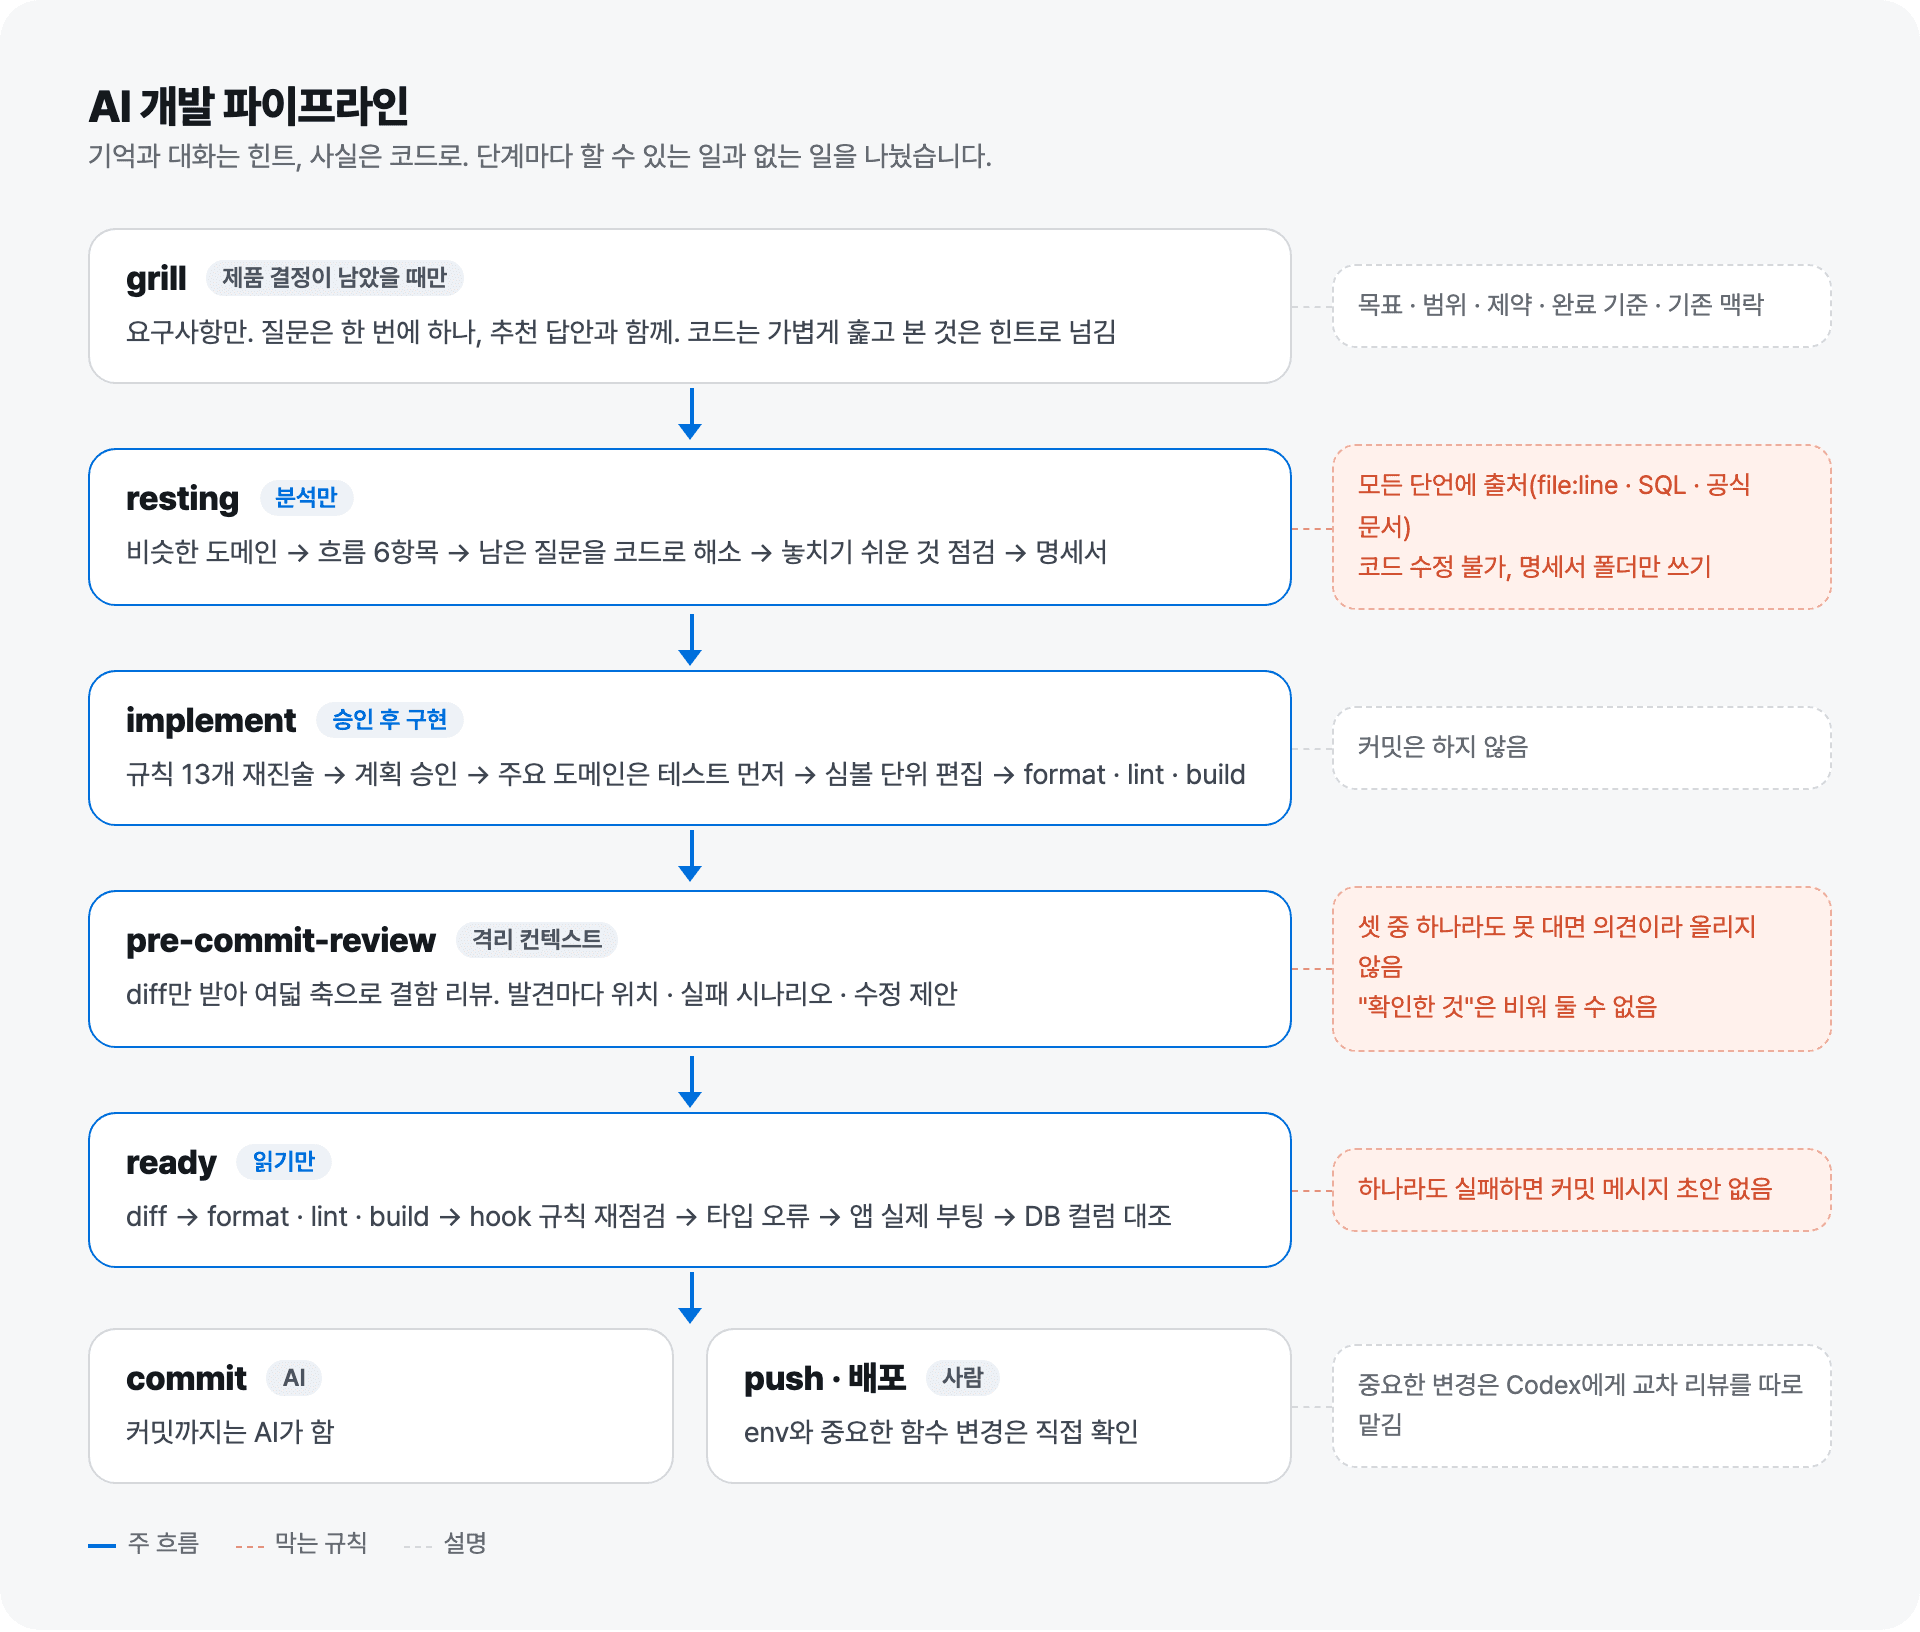
grill: 무엇을 만들지 먼저
Matt Pocock이 공개한 grill-me 스킬에서 영감을 받았습니다. 계획을 끝까지 캐묻는 인터뷰 스킬입니다. 첫 단계 이름도 여기서 따서 grill로 지었습니다.
요구사항만 다루는 단계입니다. AI가 질문을 한 번에 하나씩 합니다. 목표, 범위, 제약, 완료 기준, 기존 맥락 다섯 축입니다. 질문마다 지금 이해한 것, 막힌 결정, 추천 답안을 같이 내게 했습니다. 저는 고르기만 하면 됩니다.
첫 판에는 이 단계를 만든 이유를 이렇게 적었습니다.
LLM이 가장 놓치기 쉬운 '기존 패턴의 무비판적 답습'을 의도적으로 깨는 것
처음에는 이 단계에서 코드를 못 보게 했습니다. 이틀 뒤 바꿨습니다. 코드로 이미 답이 나오는 것까지 저에게 묻는 게 낭비였습니다. 지금은 코드를 가볍게 훑되, 여기서 본 것은 힌트로만 다음 단계에 넘깁니다. 지금은 제품 결정이 남았을 때만 grill부터 시작합니다.
resting: 분석만, 출처는 반드시
고기를 구웠으면 레스팅을 합니다. 그래서 grill 다음 단계 이름을 resting으로 지었습니다. 스킬 설명에도 "the 'resting after grilling' step"이라고 적어 두었습니다.
이 단계는 분석만 합니다. 스킬의 첫 규칙입니다.
분석 전용. 코드 작성/수정/삭제 일체 금지.
Write는docs/specs/경로에만 허용.
두 번째 규칙이 이 파이프라인의 중심입니다.
할루시네이션 zero 원칙 -
read_memory결과, 세션 대화에서 들은 정보, 과거 ADR 모두 단독 근거로 충분하지 않다.
출처마다 믿을 수 있는 정도와 확인 방법을 표로 정해 두었습니다.
| 정보 출처 | 신뢰도 | 확인 방법 |
|---|---|---|
| 프로젝트 메모리 | hint | 코드 본문으로 확인 |
| 세션 대화 | hint | 코드 본문으로 확인 |
| 과거 ADR | hint (낡았을 수 있음) | 지금 코드와 일치하는지 확인 |
| 외부 라이브러리 동작 | hint | context7로 최신 문서 확인 |
context7은 라이브러리의 최신 공식 문서를 찾아 주는 MCP 서버입니다.
그리고 말하는 방식을 막았습니다.
"memory에서 봤다", "X가 있을 것이다"라는 표현 금지. 모든 단언은
<file:line>또는SQL: ...또는context7: <library>형태의 검증 출처와 함께 작성한다.
확인하지 못한 것은 숨기지 않고 "검증 불가 - 추후 확인 필요"로 적습니다.
코드는 Serena로 읽습니다. Serena는 언어 서버(LSP)를 붙인 오픈소스 MCP 서버입니다. 코드를 파일이 아니라 클래스와 함수 같은 심볼 단위로 찾고, 참조를 따라가고, 고치게 해 줍니다. 파일을 통째로 읽지 않으니 컨텍스트를 아끼고, 함수 본문을 직접 읽으니 추측할 틈이 줄어듭니다. 그래서 resting에서는 코드 파일을 Read로 여는 것도 막고 Serena의 심볼 조회만 쓰게 했습니다. 마크다운, YAML, JSON처럼 코드가 아닌 파일만 Read로 읽습니다.
분석은 순서대로 합니다. 먼저 비슷한 도메인을 3~5개 찾습니다. 그다음 흐름을 정리합니다. 무엇이 시작시키는지, 상태가 어떻게 바뀌는지, 이벤트가 언제 나가는지, 어떤 도메인에 기대는지, 어떻게 끝나는지, 외부와 어떻게 연동하는지 여섯 가지입니다. 항목마다 파일과 줄 번호를 붙입니다.
남은 질문은 코드로 풉니다. "이미 코드로 확인된 사실은 사용자에게 묻지 말 것"도 규칙에 넣었습니다. 마지막으로 놓치기 쉬운 것을 훑습니다. 소유권, Redis 키 충돌, NOT NULL 컬럼의 백필, 인덱스, FK 순환, DTO 계약 같은 것들입니다. 그리고 명세서를 씁니다.
출처를 이렇게까지 강제한 건, AI가 틀리는 방식이 대개 근거를 잘못 고르는 것이었기 때문입니다. QA 티켓을 분석하며 적어 둔 기록 두 개입니다.
- 프런트엔드 코드 주석에 "구간 치환"이라고 적힌 걸 보고, AI는 그 구간을 LLM이 다시 써 준다고 판단했습니다. 실제 구현은 문자열 replace였습니다. 주석이 아니라 구현 본문을 봤어야 했습니다.
- "서버가 이미 이 값을 준다"고 했는데, 같은 이름의 필드가 다른 응답 DTO에 있었습니다. 필드 이름으로 검색만 하고, 그 API의 응답 DTO는 열어 보지 않았습니다.
동료가 정리한 팀 지침에도 같은 이야기가 들어갔습니다.
공통 실패 패턴은 검증을 덜 하고 분량을 더 내는 것
implement: 규칙을 다시 말하고, 승인받고, 테스트부터
resting이 쓴 명세서를 받아 코드로 옮기는 단계입니다. implement를 시작하면 AI가 먼저 CLAUDE.md의 규칙 13개를 자기 말로 다시 말합니다. 읽었다고 넘어가지 못하게 하려는 장치입니다. 그다음 계획을 세웁니다.
이 단계에는 "절대 규칙"이 넷 있습니다.
- 명시 승인 없이 편집 단계로 진행 금지.
- 검증 통과 후 즉시 종료. 사용자가 같은 턴에서 "이어서 커밋해줘"라고 해도 거부한다.
- 편집은 Serena 심볼 도구 우선.
- 검증 실패 시 커밋 메시지 권유 금지 - 원인 해결 후 재검증.
계획에는 진행, 수정, 취소 세 가지로만 답할 수 있습니다. 수정하면 계획을 다시 세우고 다시 승인을 받습니다.
인증, 사용자, 조직, 워크스페이스 같은 주요 도메인 파일을 건드리면 테스트를 먼저 쓰게 했습니다. 계획에 그 경로가 걸리면 이렇게 알리고 시작합니다.
⚠️ 이 작업은 TDD 강제 대상입니다.
테스트 러너가 없으면 멈추고 설치부터 안내합니다. 실제로 파이프라인을 만든 날, 저장소에 첫 jest 설정과 테스트가 들어갔습니다.
implement에는 당시 화제였던 ponytail 스킬도 끼워 넣었습니다. 만든 코드가 요구보다 많지 않은지, 쓸데없는 추상화를 얹지 않았는지 스스로 걸러 내는 스킬입니다.
편집이 끝나면 format, lint, build를 돌립니다. 커밋은 하지 않습니다.
ready: 커밋 전 마지막 확인
읽기만 하는 단계입니다. diff를 보고, format·lint·build를 다시 돌리고, hook 규칙을 다시 훑고, 타입 오류를 보고, 주요 도메인에 테스트가 있는지 확인합니다. entity가 바뀌었으면 실제 DB 컬럼과 대조합니다. 하나라도 실패하면 커밋 메시지 초안을 내지 않습니다.
8월에 단계를 하나 더했습니다. 앱을 실제로 띄워 보는 것입니다. 계기는 NestJS 모듈 사이의 순환 의존성이었습니다. 빌드는 통과했는데, 앱을 실제로 띄울 때에야 드러났습니다. 순환은 리팩터링으로 없앴습니다. 그래도 NestJS에서는 의존성 주입 문제가 빌드 때 보이지 않다가 실행할 때 터질 수 있습니다. 그때 커밋 메시지에 이렇게 적었습니다.
실부팅만이 유일한 그물
커밋은 AI가, push와 배포는 사람이
처음에는 AI의 git commit도 hook으로 막았습니다. 업무의 관성이었습니다. 내가 커밋하고 내가 push해야 내가 최종 확인했다는 느낌이 들었습니다.
파이프라인을 다듬으면서 생각이 바뀌었습니다.
사람이 병목인 부분은 줄여야 한다. 하지만 무슨 작업을 하고 있는지는 사람이 명확하게 알고 있어야 하고, 검토하기 쉬워야 한다.
커밋 메시지도 다시 보게 됐습니다. AI가 쓰는 커밋 메시지는 사람이 쓰는 것보다 훨씬 자세하고 깁니다. ADR, 명세서와 함께, 다음 작업을 하는 AI에게는 이전 작업의 맥락이 됩니다. 커밋이 너무 많아 지저분할 것 같았지만, 스쿼시하면 됩니다.
그래서 6월에 hook에서 git commit을 풀었습니다. push는 그대로 막았습니다.
운영 배포는 지금도 AI에게 맡기지 않습니다. 릴리즈 브랜치의 전체 diff를 다 보지는 않지만, env 변경이나 중요한 함수의 변경은 직접 확인합니다. 배포 뒤 브랜치 정리도 손으로 합니다. 느립니다. 대신 무엇을 배포해야 하고 무엇을 배포했는지 제가 압니다.
자기 코드를 자기가 리뷰하지 않게
코드를 쓴 세션에게 리뷰를 시키면 날카롭지 않았습니다. 자기가 세운 가정을 그대로 통과시킵니다. 9월에 구현에서 커밋까지 자동으로 이어지는 흐름을 만들면서 이 문제가 더 커졌습니다.
그래서 커밋 전 리뷰를 따로 떼어 냈습니다(pre-commit-review). 동료가 먼저 스펙 검사를 격리된 컨텍스트에서 돌리고 있었고, 같은 방식을 결함 리뷰에 가져왔습니다. ready가 빌드, 규칙, 타입처럼 도구가 확인해 주는 것을 본다면, 이 단계는 로직이 맞는지를 봅니다. 순서로는 ready 바로 앞에 돕니다.
리뷰어는 격리된 컨텍스트에서 diff만 받습니다. 코드를 쓰며 나눈 대화를 모르니, 쓴 쪽의 가정도 모릅니다. 보는 축은 여덟 개입니다. 회귀와 정확성, 보안과 소유권, 에러 처리, 동시성과 멱등성, 계약, 테스트 적정성, 그리고 작업하다 남긴 흔적입니다.
결함을 보고하려면 위치, 실패 시나리오, 수정 제안을 함께 적어야 합니다. 하나라도 빠지면 결함이 아니라 의견으로 보고 올리지 않습니다. 테스트는 통과하는지보다 깨질 수 있는 테스트인지를 봅니다.
스킬에 이 문장도 넣었습니다.
'확인한 것'은 비워 두지 않는다 - 무엇을 봤는지가 없으면 리뷰가 아니라 침묵이다.
만든 지 사흘 만에 잡은 것이 있습니다. 표시용 국가 이름을 8자짜리 컬럼에 넣고 있었습니다. CDN이 넘겨 주는 국가 헤더를 검증 없이 믿고 있었습니다.
다른 회사 모델에게 한 번 더
Codex에게도 리뷰를 맡깁니다. 코딩 능력이 있으면서 범용이라고 부를 만한 모델이 Codex였습니다. 제가 쓰는 방식은 코드를 넘기고 diff 리뷰를 받는 것입니다.
처음 쓴 건 4월, 문서 블록 스키마를 만들 때였습니다. Codex가 빈틈 일곱 개를 짚었는데, 확인해 보니 진짜는 셋이었고 넷은 이미 스키마에 있었습니다.
8월에는 결제와 과금 코드를 맡겼습니다. P1 결함이 16건 나왔고, 모두 고쳤습니다. 결제가 크레딧 지급으로 이어지는 구간의 중복 처리, 월말 갱신일 계산, 부분 취소의 비례 회수, Redis 장애 때의 처리 같은 것들입니다. 실제 DB로 도는 동시성 테스트도 이때 처음 만들었습니다.
과금 설계는 따로 정리했습니다. 거래소에서 배운 잔고 시스템을 AI SaaS 과금에 옮기기
리뷰 의견은 골라서 받습니다. 4월처럼 이미 있는 것을 빈틈으로 짚기도 하니, 근거를 확인한 것만 반영합니다.
팀으로 넓히기
원형은 제가 만들어 팀에 공유했고, 동료가 넓혔습니다. 지금 명령 파일의 줄 대부분은 동료가 쓴 것입니다. 동료가 더한 것은 다섯 가지입니다.
- 코드 그래프 탐색: 코드 전체를 그래프로 그려 두고, 분석할 때 파일을 뒤지기 전에 그래프부터 봅니다.
- Figma 연동: 기획 화면을 찾아 명세서에 붙입니다.
- spec-check: 명세서와 구현이 맞는지 격리된 컨텍스트에서 대조합니다.
- Codex 반론 라운드: 앞의 diff 리뷰와 달리, 코드를 볼 수 없는 Codex에게 설계를 말로 설명하고 반론을 받습니다. 최대 두 라운드이고, 근거 없는 반론은 채택하지 않습니다.
- 문서 저장소: 흩어져 있던 지침과 문서를 저장소 하나로 모았습니다. 각 코드 저장소는
.claude폴더를 여기에 링크합니다.
docs/aviko-be/
├── canon/
│   ├── adr/          아키텍처 결정 기록
│   ├── guide/        운영 가이드
│   └── policies/     기획 정책
├── conventions/      코드 규약
└── claude/
    ├── commands/     개발 단계 명령 (grill, resting, implement, ready)
    ├── skills/       pre-commit-review, spec-check, figma-*, erd, db-migration ...
    ├── hooks/        편집·명령 검사
    └── rules/
숫자로 보면 이렇습니다. 백엔드 저장소에서 AI가 함께 쓴 커밋은 3월에 제 커밋 56개 중 9개였습니다. 9월에는 24일까지 75개 중 73개입니다. 동료의 커밋에도 7월부터 붙기 시작했습니다. 다만 이 숫자는 AI가 커밋까지 했는지를 셀 뿐이라, AI를 얼마나 썼는지를 그대로 보여 주지는 않습니다.
아직 풀지 못한 것
코드 그래프는 6월에 graphify로 도입했습니다. 협업을 하다 보니 문제가 보였습니다.
- 여러 사람이 동시에 코드를 바꾸면 그래프의 신선도를 유지하기 어렵습니다.
- 신선도를 맞추려고 그래프를 다시 그리는 데 시간이 오래 걸립니다.
- 그래서 정말 효과가 있는지 의문이 남았습니다.
다른 대안을 찾고 효과를 검증하는 것은 후속 과제로 남겼습니다.
커밋 전 리뷰는 아직 저만 씁니다. 리뷰 결과도 커밋 메시지에 "HIGH 0" 같은 최종 상태로만 남겨서, 무엇을 잡았는지 다시 보기 어렵습니다.
지금 파이프라인은 하네스를 덜기도 하고 더하기도 하면서 다듬는 중입니다. 2.0 버전이 나오면 또다시 포스팅할 예정입니다.